Aggiornato a ottobre 2026: requisiti attuali di Ollama (macOS 14 o successivo), il nuovo modello predefinito
deepseek-r1:8bnato dall’aggiornamento R1-0528, una tabella per scegliere il modello in base alla RAM, la gestione del contesto, la configurazione aggiornata di Zed e due parole su DeepSeek V4.
Lo so cosa state pensando: ‘Sabato sera, finale di Sanremo, weekend lungo di San Valentino… e questo sta scrivendo un post sull’intelligenza artificiale?’
Ma vedete, mentre la mia dolce metà è persa tra una canzone e l’altra, io ho trovato una scusa perfetta per rifugiarmi nel mio angolo tech. Almeno qui nessuno mi chiederà di votare mandando un SMS al 4731…
Ma bando alle ciance, ricordi quando per far girare un’IA decente dovevi per forza connetterti a qualche servizio cloud, condividere i tuoi dati con mezzo mondo e sperare che la tua connessione internet non decidesse di fare le bizze proprio mentre stavi per concludere quel progetto importante? Bei tempi… o forse no.
Oggi, grazie a DeepSeek e Ollama, puoi portare la potenza dell’intelligenza artificiale direttamente sul tuo Mac. Niente più abbonamenti e compromessi sulla privacy, niente più latenza da far invidia a una chiamata su Marte causa VPN (tu sai dov’è, tu sai com’è, tu sai perché), e soprattutto, niente più scuse per non provare l’emozione di avere un assistente IA personale che gira in locale.
Un’IA Nata dalla Distillazione
Prima di tuffarci nell’installazione, facciamo un piccolo viaggio nel mondo della distillazione dell’IA. No, non stiamo parlando di grappa, ma di qualcosa di altrettanto potente: il processo di trasferire la conoscenza da un modello grande a uno più piccolo.
Immagina di avere un professore super esperto (il modello grande) che deve insegnare a uno studente (il modello piccolo). La distillazione tradizionale sarebbe come far osservare allo studente ogni singola mossa del professore. Ma DeepSeek fa qualcosa di diverso: usa il modello grande per creare una specie di “libro di testo personalizzato” che lo studente può studiare.
Per darti un’idea pratica, è come se volessi insegnare a un’IA junior a gestire il sistema di ticketing della tua azienda. Invece di farle analizzare migliaia di email caotiche di supporto, usi un’IA senior per trasformare quelle email in esempi chiari di domanda-risposta, creando un dataset strutturato per l’addestramento.
La Magia della Distillazione Moderna
Nel caso di DeepSeek, i ricercatori hanno usato il modello grande (R1, 671 miliardi di parametri) per generare 800.000 esempi di ragionamento strutturato, e con quelli hanno addestrato modelli più piccoli basati su Qwen e Llama. È come se avessero creato un corso accelerato di problem-solving per modelli più piccoli. Il risultato? Modelli da 7-8 miliardi di parametri che puoi far girare sul tuo Mac con prestazioni sorprendentemente buone.
A maggio 2025 è arrivato l’aggiornamento R1-0528, e con lui un nuovo distillato da 8 miliardi di parametri costruito su Qwen3. È quello che oggi Ollama scarica di default quando chiedi semplicemente deepseek-r1.
Ollama: Il Tuo Amico per Far Girare LLM in Locale
Se la distillazione è la teoria, Ollama è la pratica. È uno strumento che rende incredibilmente semplice far girare modelli linguistici di grandi dimensioni (LLM) sul tuo computer. Pensate a Ollama come a un gestore di pacchetti per modelli IA: si occupa di scaricare, configurare e far girare i modelli con pochi semplici comandi.
Rispetto a quando ho scritto la prima versione di questa guida, Ollama è cresciuto parecchio: oggi l’app ha anche un’interfaccia grafica con le sue impostazioni, offre modelli “cloud” che girano sui loro server (riconoscibili dal suffisso :cloud) e si integra con app desktop e coding agent. In questa guida però restiamo fedeli allo spirito originale: tutto in locale, sul tuo Mac.
Casi d’Uso Pratici
Coding Assistant
- Generazione di codice
- Debug
- Code review
- Documentazione automatica
Analisi del Testo
- Riassunti
- Analisi del sentiment
- Estrazione di keywords
Automazione
- Generazione di report
- Elaborazione di documenti
- Trasformazione di dati
Prerequisiti: Prepariamo il Terreno
Prima di tuffarci nell’installazione, parliamo di hardware. Per Ollama oggi servono:
- macOS Sonoma (14) o successivo (la prima versione di questa guida diceva Monterey: non vale più)
- Un Mac con chip Apple Silicon (M1 o successivi): su questi Ollama usa CPU e GPU. Sui vecchi Mac Intel funziona, ma solo su CPU, e la differenza si sente
- Spazio su disco per i modelli: da 1 a 20GB per quelli che hanno senso su un portatile
La RAM è la variabile che decide quale modello puoi usare. Ecco le versioni di DeepSeek R1 disponibili su Ollama, con il peso del download (versioni quantizzate a 4 bit, quelle predefinite):
| Modello | Download | RAM consigliata | Note |
|---|---|---|---|
deepseek-r1:1.5b | 1,1GB | 8GB | Giocattolo simpatico, utile per test veloci |
deepseek-r1:7b | 4,7GB | 8-16GB | Il distillato originale su Qwen, gennaio 2025 |
deepseek-r1:8b (default) | 5,2GB | 16GB | Distillato su Qwen3 dall’aggiornamento R1-0528: il punto di partenza consigliato |
deepseek-r1:14b | 9,0GB | 16GB (32GB per stare comodi) | Più capace, più lento |
deepseek-r1:32b | 20GB | 32GB o più | Per Mac con tanta memoria |
deepseek-r1:70b | 43GB | 64GB o più | Territorio Mac Studio |
deepseek-r1:671b | 404GB | Centinaia di GB | Il modello completo: non è roba da portatile |
Personalmente sono riuscito ad avviare il modello r1:7b con un MacBook Air M2 con 8GB di RAM (e un po’ di pazienza in più per le risposte a domande complesse).
Installazione di Ollama su Mac
L’installazione di Ollama è sorprendentemente semplice. Niente configurazioni complesse o dipendenze da gestire. Ecco cosa fare:
- Vai sul sito ufficiale di Ollama (ollama.com)
- Scarica il file per macOS
- Apri il
.dmge trascina Ollama nella cartella Applicazioni - Avvia Ollama: al primo avvio ti chiederà il permesso di creare il collegamento al comando
ollamanel terminale
In alternativa, se preferisci fare tutto da terminale:
curl -fsSL https://ollama.com/install.sh | sh
Ora siamo pronti per il passaggio successivo: far girare DeepSeek R1.
Quale Modello Scegliere
Nella prima versione di questa guida avevo scelto la versione da 14B parametri, perché era il miglior compromesso tra potenza e requisiti. Oggi il punto di partenza consigliato è l’8B: è più recente (nasce dall’aggiornamento R1-0528), pesa poco più di 5GB e gira bene su un Mac con 16GB.
Per installare e avviare il modello, apri il tuo terminale preferito e digita:
ollama run deepseek-r1:8b
Se hai 32GB di RAM o più e vuoi qualcosa di più robusto, prova il 14B:
ollama run deepseek-r1:14b
Al primo avvio, Ollama scaricherà il modello (circa 5GB per l'8B, 9GB per il 14B). Non preoccuparti se ci vuole un po’. Una volta completato il download, il modello verrà caricato in memoria ed è pronto all’uso.
Come Usare il modello

Una volta che il modello è in esecuzione, puoi interagire con esso direttamente dal terminale. È come avere una versione locale di ChatGPT, ma con alcuni vantaggi interessanti:
- Nessuna connessione internet richiesta dopo il download iniziale
- Nessun limite di utilizzo
- I tuoi dati rimangono sul tuo computer
- Nessuna latenza di rete (la velocità dipende solo dal tuo hardware)
Puoi fare domande, chiedere spiegazioni, generare codice o analizzare testi. Il modello è particolarmente bravo nel ragionamento logico e nella programmazione, grazie all’addestramento specializzato di DeepSeek.
Interazione e Comportamento
Una delle cose più interessanti di DeepSeek R1 è il suo modo di interagire. A differenza di altri modelli, DeepSeek mostra apertamente il suo “pensiero” prima della risposta, permettendoci di vedere come elabora le richieste. Nella prima versione di Ollama questo ragionamento arrivava mescolato al testo dentro i tag <think>; oggi Ollama lo separa dalla risposta finale (nelle API arriva in un campo thinking a parte), così le interfacce possono mostrarlo, comprimerlo o nasconderlo. Ecco un esempio di interazione reale che ho avuto con il modello (screenshot della prima versione della guida):
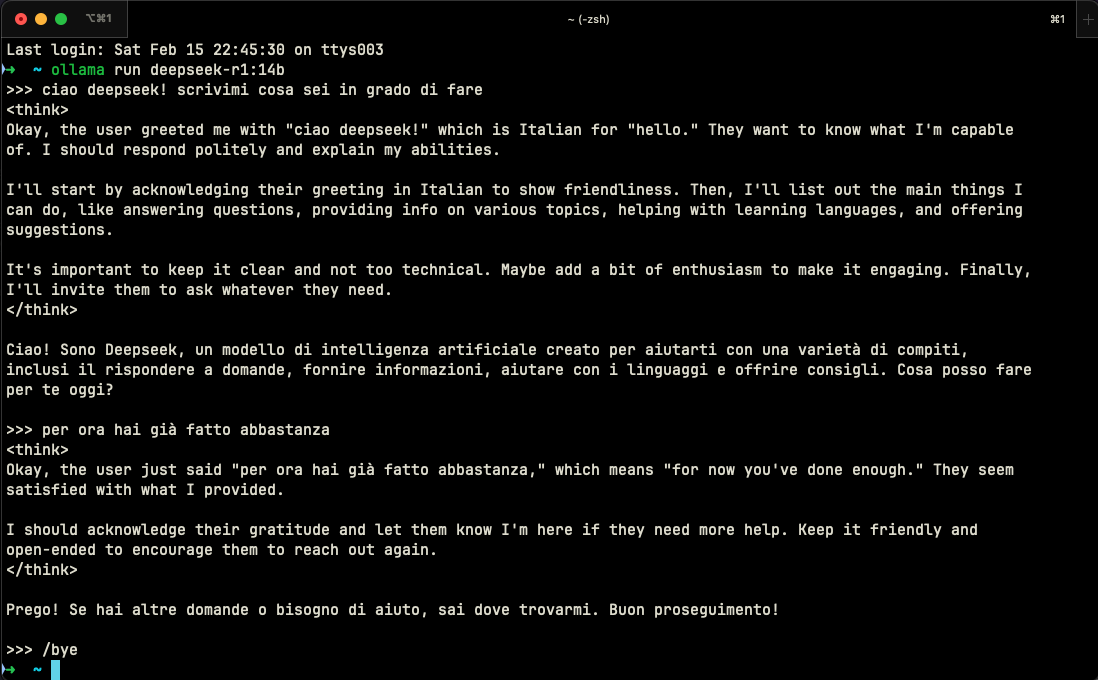
Quello che rende questa interazione particolarmente interessante è:
- Riconoscimento della Lingua: Il modello identifica automaticamente l’italiano e adatta la sua risposta
- Pensiero Trasparente: Possiamo vedere come ragiona prima di rispondere
- Adattamento Culturale: Non si limita a tradurre, ma adatta il tono e lo stile alla cultura di riferimento
- Approccio Strutturato: Organizza il suo pensiero in fasi logiche prima di formulare la risposta
Per terminare una sessione, basta digitare /bye. È semplice ed elegante, proprio come dovrebbe essere.
“Se raggiungeremo 12mila likes vi mostrerò come installare…” oh aspetta, questo non è YouTube! Mi sono fatto prendere la mano 😅 Ma già che ci siamo, vi spoilero una cosa: esiste un’interfaccia web chiamata Open WebUI che è possibile installare in locale tramite Docker, che rende l’interazione con DeepSeek praticamente identica a ChatGPT. Immaginate una bella UI pulita, conversazioni salvate, possibilità di caricare file… insomma, tutto quello che vi aspettereste da un’interfaccia moderna per LLM. Ma questa è una storia per un altro post (e no, non dovete mettere like o iscrivervi al canale per leggerlo, quando sarà pronto lo troverete qui sul blog). Per ora vi condivido uno screen:
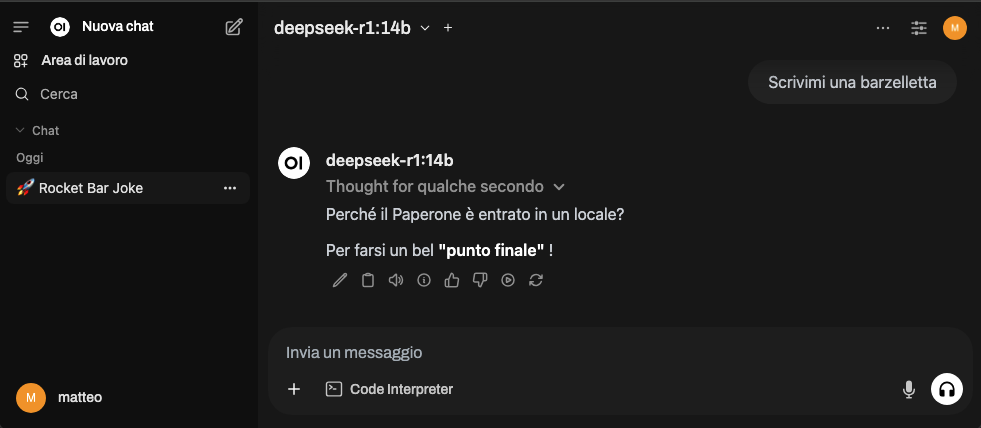
Ok.. forse occorre un po’ di fine tuning sull’humor.
Aggiornamento: ecco il link all’articolo su Open WebUI, aggiornato anche lui a ottobre 2026.
Integrazione con Zed
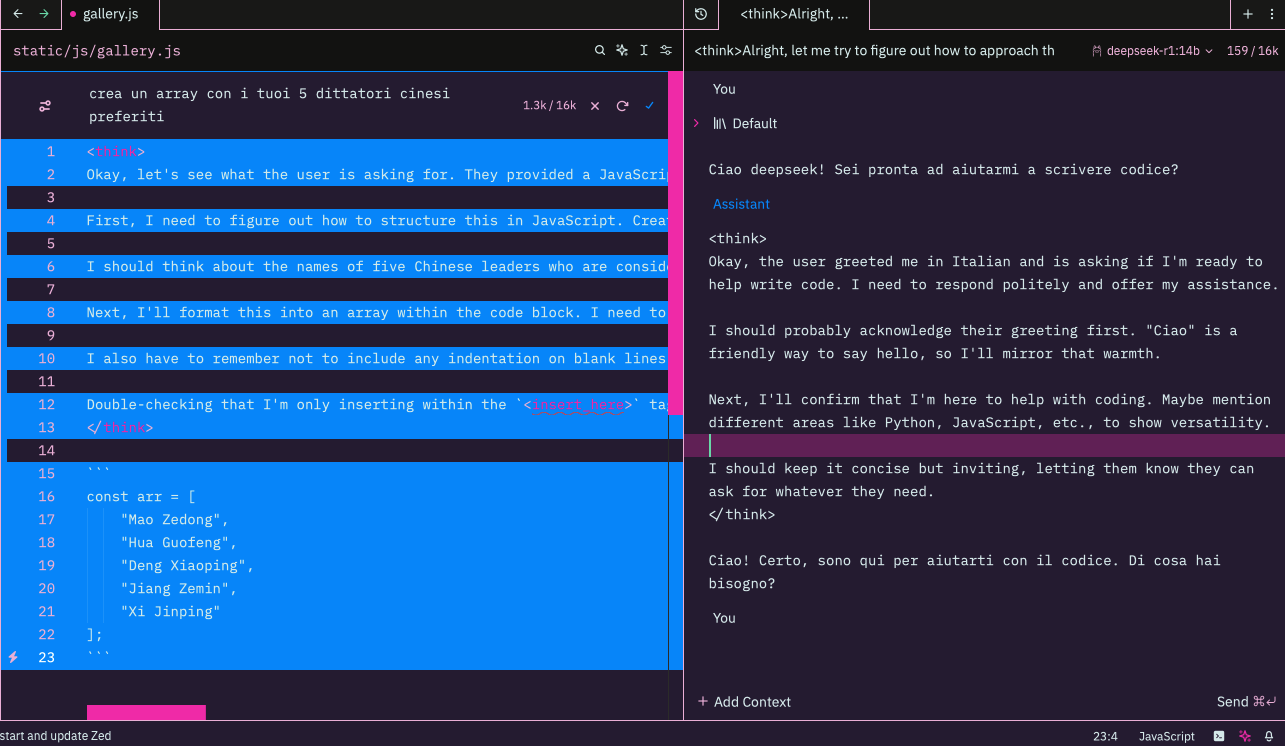
Una volta installato, il modello è disponibile anche in Zed. Per collegarlo:
- In Zed, clicca sull’icona a forma di stella in basso a destra e scegli Configure
- Sotto LLM Providers seleziona Ollama
- Verifica che l’indirizzo sia
http://localhost:11434e clicca Connect - Scegli il modello DeepSeek dalla lista dei modelli Ollama
E TEST censura superato! (O forse no, visto che ha trasformato Dittatore in Leader nel ragionamento? Scrivetemi la vostra opinione!)
Gestione della Memoria e del Contesto
DeepSeek può essere esigente con la RAM. Ecco alcuni trucchi per ottimizzare le prestazioni:
- Chiudi le applicazioni che non usi
- Usa Monitoraggio Attività per tenere d’occhio l’uso della memoria
- Se possibile, evita di far girare altri modelli IA contemporaneamente
C’è poi un dettaglio che molti scoprono a loro spese: il contesto, cioè quanta conversazione il modello riesce a tenere a mente. Ollama lo imposta in automatico in base alla memoria video disponibile: sotto i 24GB parte da appena 4.000 token. Per chiacchierare va bene, ma se gli incolli un file lungo o lo usi da un editor, a un certo punto “dimentica” l’inizio. Puoi alzarlo dal cursore nelle impostazioni dell’app di Ollama, oppure avviando il server con:
OLLAMA_CONTEXT_LENGTH=32000 ollama serve
Ricorda che più contesto significa più memoria occupata: su un Mac da 16GB, meglio non esagerare.
Troubleshooting
DeepSeek Non Si Avvia
Se il modello non si avvia prova a riavviare Ollama e/o lancia questo per verificare lo stato:
ollama ps
Se è tutto ok, dovresti leggere qualcosa del genere (questo è l’output che avevo nel 2025; le versioni recenti aggiungono una colonna CONTEXT con la lunghezza del contesto allocata):
NAME               ID              SIZE     PROCESSOR    UNTIL
deepseek-r1:14b    ea35dfe18182    11 GB    100% GPU     4 minutes from now
La colonna da guardare è PROCESSOR: se invece di 100% GPU vedi una percentuale divisa tra CPU e GPU, il modello non ci sta tutto in memoria e le risposte rallentano. Scegli un modello più piccolo o riduci il contesto.
Prestazioni Lente
Se le risposte sono troppo lente:
- Riduci il context length (memoria della conversazione)
- Abbassa i parametri temperature (creatività) e top_p (parole improbabili)
- Considera di passare a un modello più leggero
Qui trovi la guida ufficiale per personalizzare i parametri tramite un Modelfile.
E DeepSeek V4?
Se segui il blog, sai che nel frattempo è uscito DeepSeek V4. È un salto enorme, ma anche fisicamente enorme: V4 Flash ha 284 miliardi di parametri, V4 Pro addirittura 1,6 trilioni. Nessuno dei due ci sta su un Mac normale, e su Ollama li trovi solo come modelli cloud, che girano sui loro server e quindi non sono “locali” nel senso di questa guida. Per avere DeepSeek in casa propria, sul portatile, la strada restano i distillati di R1.
Perché Scegliere DeepSeek?
Chi ha provato diversi modelli IA sa che non sono tutti uguali. DeepSeek si distingue per alcune caratteristiche che lo rendono particolarmente interessante per gli sviluppatori.
Prima di tutto, la sua capacità di ragionamento è sorprendente. Mentre altri modelli possono darti risposte vaghe o generiche, DeepSeek tende a spiegare il suo processo di pensiero. È come avere un mentore che non si limita a dirti cosa fare, ma ti spiega anche il perché. L’ho visto risolvere problemi di algoritmica complessi spiegando ogni passaggio del ragionamento, rendendo anche i concetti più ostici sorprendentemente accessibili.
Sul fronte delle prestazioni, DeepSeek è come una Tesla Model 3: compatto ma potente. I modelli da 7-8B girano bene anche su un MacBook Air, cosa che non si può dire di tutti i suoi concorrenti. L’avvio è quasi istantaneo, e la memoria viene gestita in modo intelligente: niente più ventole che sembrano voler decollare dopo cinque minuti di utilizzo.
Ma forse il vantaggio più importante è la privacy. In un’epoca in cui i nostri dati vengono raccolti, analizzati e venduti da ogni servizio online, avere un’IA che funziona completamente in locale è come trovare un’oasi nel deserto. I tuoi prompt, le tue domande, i tuoi esperimenti rimangono sul tuo computer. Punto. Niente cloud, niente tracciamento, niente “questa conversazione potrebbe essere utilizzata per migliorare i nostri servizi”.
Conclusione
DeepSeek su Mac non è solo un esperimento tecnologico: è un passo verso un futuro dove l’intelligenza artificiale è veramente personale e privata. È come avere un assistente sempre disponibile, che non ha bisogno di connessione internet e non condivide i tuoi dati con nessuno.
La cosa più bella? Era solo l’inizio. Da quando ho scritto la prima versione di questa guida i distillati sono migliorati, Ollama è diventato più comodo e i modelli piccoli fanno cose che un anno fa sembravano impossibili su un portatile. E la tendenza non accenna a fermarsi.
Risorse Utili: